Pixel 8aでLinuxターミナルアプリが使えるので、外出先でも通勤中でもOSS開発ができる
スマホはみんなニュース見たりして朝を過ごしてるだろうけど、いまどきならOSS活動しながら電車通勤することもできるのです。Pixel 8aでヘッドレスFirefoxだってRuby 4.0だってバッチリ動くのです pic.twitter.com/BEgPvqR2sl
— Yusuke Iwaki (@yi01imagination) January 20, 2026
最近は、Claude CodeやCodex CLIを使っての puppeteer-ruby の建て直し、puppeteer-bidiの開発、をもっぱらやっている。
なぜかって、Firefox対応を怠っているうちにどんどんpuppeteer-rubyの利用者が減ってきてしまったから。決定打はこれ。
そんなわけで、手作業での移植を頑張るのではなく、とにかく生成AIコーディングエージェントに型にはまった移植をさせまくることをやって、puppeteer-rubyの不安定さと機能不足を補い、Firefox対応はpuppeteer-bidiという別のGemで実現する、というのを一気にやっている。
生成AIを動かすマシンが(物理的に)重い&大きい問題
生成AIを動かすのは、できればmac miniみたいなのでずーーっと動かしっぱなしにして外からSSHで見て様子見するだけ、とかにできればいいのだろうけど、どうも自宅サーバーをまた作りたいかというとそうでもないし、VMの世話もしたくない。
そうなると、どうしてもMacbook Airなどを持ち歩いてやることになるわけだが...
AIコーディング登山。Macbook重いので、ちゃんとバッテリーもちがする富士通LIFEBOOKあたりにしたい pic.twitter.com/vwZolSgEON
— Yusuke Iwaki (@yi01imagination) December 20, 2025
私は一体何をやってるんだと自問自答するしかない pic.twitter.com/6e4D0koN7Q
— Yusuke Iwaki (@yi01imagination) January 17, 2026
どうしてもこのような病的なことをやらざるを得なくなる。山にPCを持って上がること自体が異常なのはおいといて、Macbook Air 15インチは生成AIが動く様子を眺めて時々修正するだけにしては、ただただ重くて大きい。
PCが軽いからといって解決するか?
メルカリでぽちって13インチMacbook Airにしてみた。ちょっと軽いが、まだ重いし、びみょーーーーに15インチとキーボードの感覚がちがって扱いづらい。結果2日で売ることになった。
外でRSpec書く民としては、やはり15インチは重すぎたなと、13インチのAirにしてみて気づく pic.twitter.com/690G7lRC08
— Yusuke Iwaki (@yi01imagination) January 5, 2026
Chromebook Flex化したLifebook だと、重さはMacbookの半分なので苦痛は半減。ただこちらは(Macbook Airもそうだけど)ノートを閉じるとAIエージェントが動かなくなってしまうので、どうしても半開きで持って歩かないといけない。
Claude Codeを動かしながら通勤する頭おかしい人。Macbookは重すぎすので、700gくらいの富士通Lifebookがこういう時には役に立つ(?) pic.twitter.com/axfxD5Lhap
— Yusuke Iwaki (@yi01imagination) November 11, 2025
AndroidのTerminal appはChromeOSのcrostiniと同じくDebianが動作する
ChromeOS flexでPlaywrightのRubyクライアントも開発ができるということは、DockerだってFirefoxだって仮想環境上のDebianで動くわけだ。
Androidに乗っかっているTerminal appは、ChromeOSのcrostiniとほぼ同じで、違いはというとXウインドウがないくらいだ。探してみればDockerを動かしたりClaude Codeを動かしたりしている猛者はいる。
実際にやってみたところ、たしかにヘッドレスFirefoxは動いたし、ヘッドフルなFirefoxだってxvfb-runすれば動いた。本当に素直ーなLinuxなのである。そうとなれば、Codex CLIとClaude Codeさえ入れれば...
いまChromebook持ち歩いてるけど、Pixel 8aにLinuxターミナルアプリが降ってきてるということは……もしかしてPixel8a持ち歩いてOSS開発(Claude Code & Codex)登山できてしまう?!
— Yusuke Iwaki (@yi01imagination) January 10, 2026
山の中だろうと通勤電車だろうと、Claude CodeとCodex CLIでOSS活動ができちゃうぞ! これはとても革新的!
なんとかPixel8aのほうのCodexに作業引き継いだ pic.twitter.com/gIOrCWqzH0
— Yusuke Iwaki (@yi01imagination) January 17, 2026
電車が遅れてる間にdownload.spec.tsをRSpecに移植ができたっぽい。 pic.twitter.com/36qeLsTLgW
— Yusuke Iwaki (@yi01imagination) January 20, 2026
デバイスから日本語を排除して英語おんりーにしてしまえば、ソフトウェアキーボードも意外と使いやすく、重宝している。
唯一の難点を上げるとすると、よくクラッシュする点。
唯一Pixel8aでバイブコーディングをする難点を挙げるとすれば、所詮はAndroidだということ…。 pic.twitter.com/qwq1wzuLGa
— Yusuke Iwaki (@yi01imagination) January 11, 2026
これまでなかなかパソコンを広げるのが難しかった満員電車や買い物中などでも、思い立ったときにClaude CodeやCodex CLIを動かすくらいならPixel 8aでできるようになったので、よりスキマ時間の活用ができるようになりそうだ。
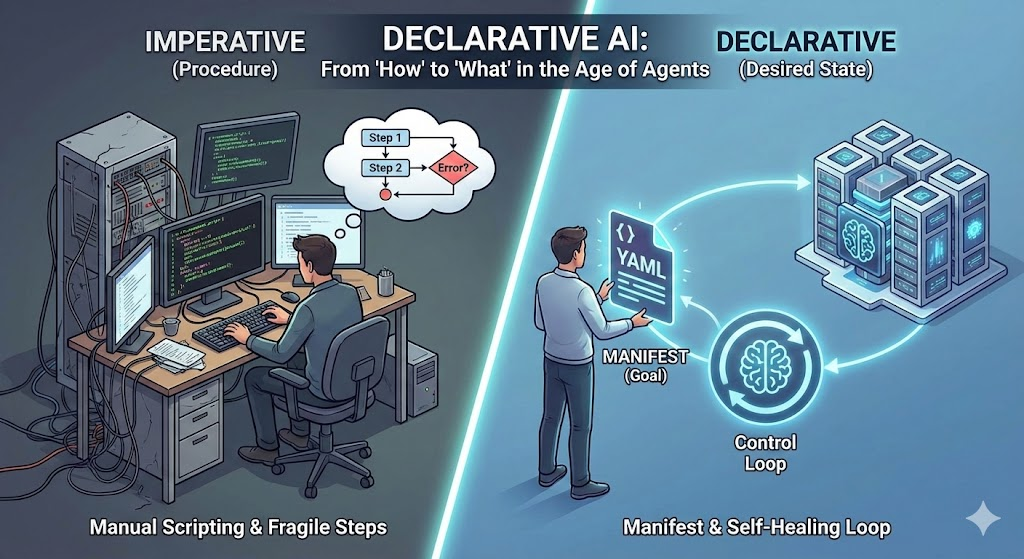
生成AIは宣言型へ向かうのでは説
(この記事はClaude Codeで大半を書いたものです)
前提: この記事の想定読者
この記事は、ChatGPTにアドホックに質問するようなユースケースを想定していない。
想定しているのは、生成AIを業務フローに組み込もうとしている人だ。問い合わせ対応の自動化、ドキュメントからの情報抽出、社内ナレッジの検索と要約。こうした用途でAIをプロダクションに載せようとすると、すぐに「ワークフローをどう設計するか」という問題にぶつかる。
この問題に対する一つの視座として、フロントエンド開発とインフラ運用の世界で起きたパラダイムシフトを振り返りたい。
まえおき: UIは「どう作るか」から「どうあるべきか」へ変わった
jQueryの時代、開発者は「この要素を取得し、この値を書き換え、このクラスを付与する」と手順を書いていた。React以降は「stateがAならUIはこう、Bならこう」と状態と結果の対応を書く。手順の記述から、あるべき姿の宣言へ。これは単なる流行ではなく、複雑さを扱うための必然的な抽象化だった。
宣言型UIの本質 ― Reactは何を変えたのか
Reactの宣言型アプローチを支えるのは、いくつかの設計原則だ。
仮想DOMと差分検出(Reconciliation)
開発者はUIの「あるべき姿」を宣言する。Reactは仮想DOMを使って「今」と「次」を比較し、変更が必要な部分だけを実際のDOMに反映する。厳密には汎用的なツリー差分ではなく、キーや要素型などのヒューリスティクスで同一性を判定する仕組みだが、開発者から見れば「どの要素をどう書き換えるか」という手順を自分で書かなくてよくなった、という点が重要だ。
純粋性を前提とした設計
Reactは、コンポーネントが同じpropsとstateから同じJSXを返すことを期待している。副作用はuseEffect等に寄せる。この原則に従うことで、挙動が予測可能になり、再レンダリングの最適化も効くようになる。もちろん、Math.random()やグローバル変数を参照すれば簡単に非純粋になる。Reactが純粋性を保証してくれるわけではない。あくまで開発者が守るべき規約だ。
データフローの一貫性
Reactはデータが親から子へ一方向に流れることを基本とする。Flux/Reduxのような設計では「単一の情報源(Single Source of Truth)」が強調されるが、これはReact自体の必須要件ではない。現実のアプリでは状態がコンポーネントローカル、URL、サーバーキャッシュ、フォームなど複数箇所に分散することも多い。それでも、状態の出どころを明確にし、一貫したデータフローを保つことで複雑さを抑える、という設計思想がReactの背景にはある。
これらが組み合わさることで、開発者は「How(どうやるか)」ではなく「What(何であるべきか)」を書けるようになった。
インフラでも同じことが起きた ― Kubernetesの事例
このパラダイムシフトは、フロントエンドに限った話ではない。インフラの世界でも同じ転換が起きている。
かつてサーバー管理者は、詳細なデプロイ手順書を片手に、一歩ずつコマンドを打ち込んでいた。Kubernetes(K8s)の登場以降、開発者は「あるべき状態」をYAMLに記述するだけでよくなった。「このDeploymentは3つのレプリカで動いていること」「このServiceはポート80で公開されていること」。
K8sの設計を支えるのは「Reconciliation Loop(制御ループ)」だ。現在の状態を常に監視し、あるべき状態との差分を検出し、差分を埋める操作を自動で実行する。このループが回り続けることで、システムは自己修復する。コンテナが落ちても、ノードが死んでも、K8sは黙々とあるべき状態に戻そうとする。
フロントエンドとインフラ。領域は異なるが、起きたことは同じだ。複雑さが一定を超えたとき、手順を書く命令型は限界を迎え、あるべき姿を書く宣言型へ移行した。
現在の生成AI ― 命令型の世界
翻って、現在の生成AIをプロダクションに組み込もうとするとどうなるか。
「問い合わせを受けたら、まずカテゴリを分類するプロンプトを実行し、その結果に応じてナレッジベースを検索し、検索結果を元に回答を生成する」。
これは本質的に、jQueryでDOMを操作していた時代、あるいはデプロイ手順書でサーバーを構築していた時代と同じだ。人間が司令塔となり、一歩ずつ処理を定義する。一箇所の出力が想定と異なれば、後続のタスクはすべて崩壊する。
今のAI活用は、極めて命令型の世界に留まっている。
命令型の限界 ― ワークフローを組んだことがある人なら知っている
命令型の限界は、AIに限った話ではない。ワークフローシステムを触ったことがある人なら、この面倒さには覚えがあるはずだ。
例1:ソフトウェア開発のイテレーション
「概念設計→DB設計→実装→テスト→失敗したら戻る」という流れをタスクの連鎖として定義するのは難しい。仮に定義できたとして、「テスト設計の担当者を増やしたい」となった瞬間、フロー全体を作り直す羽目になる。
例2:技術サポート対応
「問い合わせを受け、技術担当に調査を依頼し、結果をレポートにまとめる」。人間がこの役割分担を想像するのは容易だが、これをタスクレベルで分解してフローに落とし込むのは骨が折れる。
共通する問題
命令型のフローは「事前にすべての分岐と手順を定義する」ことを要求する。現実の業務は例外だらけで、変更も頻繁に起きる。フローが複雑になるほど、修正コストが指数的に増える。これはjQueryでDOMを直接操作していたときの問題、手順書でサーバーを構築していたときの問題と、構造的に同じだ。
宣言型AIという解 ― ReactとKubernetesの設計思想はAIにも適用できる
ReactとKubernetesに共通する設計思想は、比喩としてAIの世界にも対応させることができる。
| 共通する設計思想 | AIでの対応(比喩) |
|---|---|
| 差分検出と反映 | 状態監視と差分実行 |
| あるべき姿を宣言し、フレームワークが現状との差分を計算して反映する | 人間はあるべき状態を宣言し、AIが現状との差分を見て必要なアクションを実行する |
| 純粋性・冪等性 | 条件と振る舞いの対応 |
| 同じ入力なら同じ出力を期待。副作用は明示的に分離 | 同じ条件なら同じ振る舞いを期待。外部操作は明示的に定義 |
| データフローの一貫性 | コンテキストの一元管理 |
| 状態の出どころを明確にし、一貫したフローを保つ | ルール・履歴・状態の出どころを明確にし、AIの判断はそこから導出 |
具体的には、人間は以下のような宣言をAIに渡すことになる:
- 「テストが失敗したら、原因を特定して修正案を提示する」(条件→振る舞い)
- 「未読メールが10件を超えたら、優先度の低いものをアーカイブする」(状態監視→差分実行)
- 「技術的な問い合わせには、まずログを確認し、必要なら担当者にエスカレーションする」(ルールからの導出)
人間は「ゴール」と「制約」と「判断基準」を宣言する。AIはその宣言に基づいて、状況に応じた手順を自律的に組み立てる。Reactが仮想DOMで「How」を自動計算したように、K8sがReconciliation Loopで「How」を自動実行したように、AIが「How」を自動で導出する。
ただし、この対応には本質的な非対称性がある。ReactのDOM更新はブラウザ内で閉じている。K8sのController操作もクラスタ内で閉じている。失敗しても再レンダリングやリトライで回復しやすい。一方、AIの「差分実行」は外部世界に副作用を起こす。メールを送る、データを書き換える、顧客に通知する。一度実行すれば取り消せないことも多い。だからこそ、宣言型に寄せるほど、ガードレール ― 権限管理、人間による確認、取り消し手段、監査ログ ― の設計が重要になる。
技術的な現在地 ― 何があり、何が足りないか
すでにある要素技術
エージェント技術は実用段階にある。ツール呼び出し、マルチステップ推論、自己修正。AIが複数の手順を自律的に実行する能力はすでに動いている。コンテキストウィンドウの拡大により、状態や履歴を保持したまま長期タスクを遂行できるようになった。MCPのような外部接続の標準化も進み、AIが外部システムを操作する手段は整いつつある。
まだ標準化されていないもの
一方で、ReactやK8sのReconciliationに相当する抽象化 ― AIが「世界の状態」を継続的に観測し、あるべき状態との差分を検出して必要なアクションを決定する仕組み ― は、一般解としてはまだ確立していない。
「状態監視→差分検出→実行」というパターン自体は、LLM以前から監視ツールやジョブスケジューラ、イベント駆動アーキテクチャとして存在する。LLMを組み込んだ実装も増えている。だが、ReactやK8sのように「開発者が宣言を書けば、あとはフレームワークが面倒を見てくれる」という開発者体験には至っていない。
非決定性という本質的な違い
ReactやKubernetesとの対比で見落としてはならない点がある。
ReactのレンダリングもK8sのControllerも決定論的だ。同じ仮想DOMからは常に同じDOM操作が導出される。「レプリカ数が3であるべきところ2しかない」なら、「1つ起動する」という判断は一意に決まる。
一方、AIの判断は確率的であり、同じ入力から異なる出力が生まれうる。
たとえば「問い合わせの未対応件数は常に5件以内でなければならない」「技術サポートはログとドキュメントを材料として調査を行う」といった宣言を並べたとする。しかし、実際のタスクをこなすにはこれだけでは足りない。ログに該当する記述がなかったらどうするか。ドキュメントが古かったら。顧客が急いでいたら。宣言でカバーされていない状況に直面したとき、AIはその隙間を自分で埋めて判断するしかない。
古典的なAIでは、評価関数を人間が設計し、最も評価値の高い遷移先を選んでいた。判断基準は明示的だった。LLMベースのAIでは、この評価基準がモデル内部に暗黙的に学習されている。宣言の隙間を埋める判断もまた、モデルに委ねられている。
そしてその判断が人間の期待から外れたとき、「AIが嘘をついた」と見なされる。ハルシネーションと呼ばれる現象の少なくとも一部は、この構造から生まれている。宣言が不十分なとき、AIは何かを選ばなければならない。その選択が人間の暗黙の期待と一致する保証はない。
宣言をより精緻にするのか、判断を制約で縛るのか、不確実なときは人間に確認させるのか。そこが、宣言型AIの時代においても引き続き人間が注力すべき部分となる。
パラダイムシフトはいつも静かに起きる
Reactが登場したとき、多くの開発者は「jQueryで十分」と思っていた。Kubernetesが登場したとき、多くの運用者は「手順書とシェルスクリプトで十分」と思っていた。だが複雑さが一定を超えると、命令型は保守不能になる。そして人々は宣言型へ移行した。
生成AIも同じ道を歩む。今はまだ「プロンプトを工夫すれば何とかなる」「ワークフローを細かく定義すれば動く」という段階にいる。だが、AIに任せたいタスクが複雑になるにつれ、命令型は限界を迎える。
もちろん、完全な宣言型にはならない。Reactでもイベントハンドラは命令的に残り、K8sでもCI/CDパイプラインやアラート対応は命令的に書くように、AIでも「いつ人間が承認するか」「どこで処理を止めるか」といった制御は命令的に書くことになるだろう。宣言(ゴール・制約・判断基準)と命令(権限・承認・停止条件)のハイブリッドが現実解になる。
それでも、重心は宣言型へ移る。これは革新ではなく、複雑さを扱うための必然だ。
生成AIの力を借りて、ブラウザ自動操作ライブラリを新たに開発した
背景
2025年、ついにFirefoxがCDPで自動操作できなくなり、WebDriver BiDiへの対応がどうしても必要になった。
以前から作っていたpuppeteer-rubyというライブラリでも、そのようなissueは立っていたものの、趣味の時間でpuppeteer-rubyをFirefoxだけBiDiプロトコルを使うように変えるなんてのは大変だ。
いっぽうで、Kaigi on Rails 2024の準備をしていたときから、BiDiでFirefoxを自動操作する実験的なコード自体は作っていた。
今年はコーディングエージェントが大幅に進化した1年でもあり、そろそろAI主導で何か作れるんじゃなかろうかと思い立って、10月ごろから実はPuppeteerをベースとしつつ WebDriver BiDiを実装する取り組みをしていた。また、従来のpuppeteer-rubyではスレッドベースのconcurrent-rubyを使って並列処理をしているのだけど、こいつがやっぱり時々落ちるテストの原因にもなっていることから、次つくるとしたら Fiberベースの socketry/async を使ってみたいと思っていたので、AI主導でやらせるならいけるだろうとおもって、これも採用した。また、型補完が効きやすいようにRBSとかsteepとかもどうせなら使ってやろう、ということでrbs-inlineとsteepも採用した。
できたのがこちら
puppeteer-rubyの時よりも、コードを書くのが楽なライブラリになったと思う。
Rubymineでもばっちり動くには動いた。 pic.twitter.com/KqQZjZEuqb
— Yusuke Iwaki (@yi01imagination) 2025年12月23日
で、自慢がしたいというわけでもなく、これを作るまでにあった苦労や発見を一応書き留めておきたいというのがこの記事の趣旨。
Claude CodeかCodex CLIかGemini CLIか
まずは、コーディングエージェントの選定の話から。
だいたいのAI比較記事で書かれていることもあるが、 TODOアプリやブロック崩しゲームを作らせたくらいだと本当の実力はわからない んじゃないのか?というのが実際使ってみての最初の感想。まず圧倒的にClaude Codeが優れている。そして、Codex CLIはClaude Codeではどうしてもうまくいかない部分やコードレビュー専用と割り切ればいいかんじ、といった印象を受けた。自分だけでなく、Kickflowの人 も最近似たようなことは書いてたし、他にもそのような話は聞いたこともあるので、おそらくシニアエンジニアだと概ね Claude Codeメイン + Codex CLIで細かいところを詰める、というのが2025年現在の平均的な使い方なんだろう。
ちなみに、Codexが普段遣いしづらいのは実物を見てもらえたらわかると思うが、
- docs: add Node Puppeteer API coverage doc by YusukeIwaki · Pull Request #27 · YusukeIwaki/puppeteer-bidi · GitHub
- docs: tighten README and add development guide by YusukeIwaki · Pull Request #30 · YusukeIwaki/puppeteer-bidi · GitHub
↑こういうプルリクを作ってくるのがCodex。
- Fix Page.close to properly wait for closed state by YusukeIwaki · Pull Request #24 · YusukeIwaki/puppeteer-bidi · GitHub
- feat: implement Locator API for robust element interactions by YusukeIwaki · Pull Request #40 · YusukeIwaki/puppeteer-bidi · GitHub
↑こういうプルリクを作ってくるのがClaude Code。
エンジニアとしてどちらが嬉しいかは、10人いたら10人がClaude Codeのプルリクを好むはずだ。
コードの修正をした際にも、Claude Codeは高確率で単体試験を実行してリグレッション確認をしてくれるが、Codexのほうは言わないと単体試験のリグレッション確認はしてくれない。このような挙動から、おそらく大半のエンジニアに好まれるのはClaude Codeの方だろう。
丸投げでは何も出来上がらない
これは最近Qiitaの記事でも書いた話。
人間でも、「Puppeteerのコードみて、WebDriver BiDiでFirefoxを自動操作するコードをRubyに移植して」なんて指示で完遂できるエンジニアは存在しない。
- 作業計画
- 実行
- 単体試験&レビュー
基本的にはこの3点セットを機能ごとに繰り返しやっていけばAIを活用したコーディングはできるのだけど、特にAIコーディングで重要なのは事前レビューと、単体試験による確認だ。
普段から規模の大きなプルリクを見ているエンジニアにとっては何でもないのだが、「300行を超えるプルリクになった場合には分割をしよう」なんてルールがあるような良い環境で育ったエンジニアにとっては、おそらく1000行単位の変更のあるプルリクを繰り返し見ることは容易ではない。
いっぽうで、AIコーディングで恩恵を得ようとするならば、1000~3000行くらいの差分のプルリクでも普通にこなしていく必要がある。(あくまで私個人の感覚)


ただ、コードを突きつけられてそれをレビューするというのは基本的に苦行だ。なので、その作業負荷を減らすのがポイント。
たとえば、
- 作業方針が間違っているとどこで何やっているのか把握が難しくなるので、AI自身が把握している作業内容を語らせて、事前に作業内容のレビューをする
- 3000行のコードにバグが潜んでいてもほぼ気付けないので、壊れたら困る部分は単体テストで不具合が出ないようにガードする
などだ。
「オフショア開発」のディレクション経験とAIコーディングエージェントの扱いは似ている
ちなみに、少し横道それた話になるが、オフショア開発をしたことがあるかどうか、はAIコーディングにおいては割と重要なファクターになるかもしれない。
日本における開発委託は、よほど質の悪い会社じゃない限り、多くの場合は1から10まで言わなくても通じる人がどこかしらにいて、そういう人が引っ張っていくので、委託する側が多少はタスク分解できていなくてもどうにかなることが多い。
一方で、オフショア開発となると話は結構違っていて、10いっても1動くかどうかという意思疎通が難しい人をなんとか使わないといけないこともあるし、そうでなくても10言って7くらい動けば御の字くらいに思っておかないといけない。どちらのケースにおいても、多少の支離滅裂でもいいから10言う努力をまず必然的にさせられるということだ。
あとは、オフショア開発では、あまりにも意思疎通が難しい人がいた場合には、別のメンバーに変えてもらうことも成功の鍵だ。当たり前の事のように思えるが、実際にそれがされず、能力に満たない初学者をひたすら使おうと頑張っている現場は意外と多い。"別のメンバーに変えてもらう"というのは、メンバーのアサインメントを変更する権限をもつ上長を特定し、あらかじめ「我々の仕事をするための能力・要件を満たしてない場合にはあなたにフィードバックしますよ」と握っておくということ。より本質的にいうと、どこかで見切りをつけて仕切り直す、そういう勘所が必要だということだ。
AIコーディングにおいても、 多少の支離滅裂でもいいから、思考に必要な情報はとにかく与える ことと、 うまくいかないときには一度セッションを作り直す という態度は非常に重要で、それをやっていないと変な推測が走ったりハルシネーションを起こしたりする。過去にオフショア開発をやっていると、これらの勘は必然的に鍛えられるので、割とすんなりAIコーディングエージェントにも順応できそうだ。
趣味のコーディングと、本当に使えるものを作るコーディングは別
AIでコーディングをすると、どうしても生産性が高まることを期待してしまう。そして、単位時間あたりのコード生成量の大きさに感動してしまう。ここまではいいのだが、 その大量生産されたコードが正しく動くことはどうやって確認できる だろう?
趣味のコーディングであれば、思いつくいくつかのユースケースを動かしてみてなんとなく動けば良いだろう。ただ、そんな精度のツールを世の中で使ってもらうことはできない。
puppeteer-bidiも初期は本家Puppeteerとは多少違ったプロトコルで動いてそうなのを許していたが、waitForNavigationを実装するときに限界が来たので、その時点から「動けばヨシ」を諦めて、忠実に移植して本家と同様のテストも全passする、テストが通らない場合には本家との動作の差分がないかを調べる、ということで真面目なソフトウェア開発をやらざるを得なくなった。
そうなると、生産性向上のためにAIを使うといった感覚はほぼなく、オフショア開発よりは思い通りに動いてくれるやつがそこにいるから便利に使わせてもらう、くらいの感覚だ。もはや趣味というか仕事をしている気分。
GPT-5.2という超人的なやつ
Claude Codeはそんなに深く考えてはくれない。良く言えば。要領がいい、効率がいい。だけど、しっかり考えて解決しないといけない問題に向き合ってくれず、テストを一旦スキップさせて終わらせようとしたり、テストをスキップさせようとしたり、テストをスキップさせようとしたり、...そんなふうに最適化されているのがClaudeだ。仕事をほどほどに早く終わらせようとすること自体はいいんだけどね。感覚的には、平均的なミドルクラスのエンジニアができなさそうなことを任せると、テストをスキップさせるなどおかしな方向に動き出すことが多い。
従来もGitHub Copilot + GPT-5を併用することでそのあたりは解決できていたのだけど、現時点においてはGPT-5.2-codexがそこに対する最適解だ。
Claude Codeは深く考えてくれないだけではなく、人間の言うことがとりあえず正しいみたいなスタンスがあるが、Codexは真実はいつも一つ!という感じなので、コードレビューの強い味方である。
たぶん、こんなかんじで質問の問いに的確に答えられる人類は、世の中に100人いるかどうかな気がするんだけど、GPT-5.2すんごい賢いぞ。 pic.twitter.com/2bMCiaxlHW
— Yusuke Iwaki (@yi01imagination) 2025年12月20日
コードレビューをさせるととても鋭い指摘がされ、自分で直してくれるため、大規模なコードでも品質高く仕上げることができる。reasoning については、 xhigh だと30分くらい考え込んでしまうこともあるので、自分の場合には high にしている。
ミドルクラスのエンジニアができなさそうな問題を与えても、勝手にテストをスキップさせたりはしないで、Puppeteerのコードを片っ端から読みに行って原因追求を深く考えるというのがCodex。15分くらいかかることもあるが、その正確性にはClaude Codeとは比じゃなく信頼ができる。
生成AIのコーディングエージェントを使うために今必要なことは...
みんなに使ってもらうようなシステムやライブラリは相変わらず時間をかけて作る必要がある。そして「経験と勘」はコーディングエージェントでもさらに必要とされている印象がある。
DDDがほどほどにわかって、テストコードを書けるような設計ができて、おかしな動きをしてるなーこれじゃ終わらんなーと思ったらセッションを一旦切って仕切り直して、管理しやすいように進捗管理させて、...
趣味で開発してたはずなのに、なんだよこれはもう仕事じゃねーか!!そんな時代になってきています、はい。
趣味で楽しくコードを書く時間、というのは今後本格的になくなっていくのかもしれない。
おまけ
なんとなく Gemini 3.0 の画像生成で、このブログ記事のアイキャッチ画像を作らせてみたら、こんな感じになった。
本採用するにはちょっと合ってないかなー、見送りで!!w
